Un cluster Proxmox regroupe plusieurs serveurs Proxmox VE dans un même ensemble d'administration. Il apporte une configuration distribuée, une vue commune des machines virtuelles et les mécanismes nécessaires à leur migration ou à leur reprise. Il ne suffit pourtant pas de relier deux hôtes et d'activer « HA » pour rendre une application disponible : le quorum doit rester valide, les données doivent être accessibles depuis le nœud de secours et ce nœud doit pouvoir absorber la charge. Ce guide explique ces dépendances, compare les architectures à deux et trois nœuds et montre ce que la haute disponibilité change réellement lors d'une panne. L'objectif est de pouvoir valider une architecture avant de déployer des charges de production, sans confondre cluster, stockage distribué, migration à chaud et sauvegarde.
À retenir
- Proxmox recommande au moins trois nœuds pour disposer d'un quorum fiable.
- Un cluster à deux nœuds demande un vote extérieur, fourni par un QDevice indépendant, et reste plus délicat à exploiter.
- La haute disponibilité redémarre une ressource après une panne ; elle ne transforme pas ce redémarrage en continuité instantanée.
- Ceph n'est pas obligatoire, mais les données doivent être exploitables par le nœud qui reprend la machine virtuelle.
- Réplication et sauvegarde répondent à des risques différents : une copie active ne fournit pas d'historique restaurable.
Sommaire
- Ce qu'un cluster change
- Quorum et Corosync
- Réseaux du cluster
- Choisir le stockage
- Comprendre la haute disponibilité
- Deux ou trois nœuds
- Checklist de conception
- Périmètre Tomco
- Questions fréquentes
En un coup d'œil — quel niveau d'architecture choisir ?
| Architecture | Ce qu'elle apporte | Compromis principal | Usage cohérent |
|---|---|---|---|
| Un nœud Proxmox | Virtualisation et administration centralisée | Panne de l'hôte = arrêt des VM | Laboratoire, service restaurable |
| Deux nœuds + QDevice | Quorum à trois votes et capacité de reprise | Dépendance au vote extérieur, marge de capacité limitée | Petit périmètre avec contraintes acceptées |
| Trois nœuds | Majorité native après la perte d'un nœud | Investissement et exploitation supérieurs | Production avec HA lisible |
| Trois nœuds + Ceph | Calcul et stockage distribués | Réseau, mémoire et supervision exigeants | Plateforme sans baie de stockage unique |
Ce qu'un cluster Proxmox change réellement
Proxmox VE utilise pmxcfs, son système de fichiers de configuration distribué, et Corosync pour propager l'état du cluster. Les nœuds partagent ainsi les définitions des machines virtuelles, des conteneurs, des utilisateurs, des rôles et des paramètres de haute disponibilité. L'administration reste multi-maître : un nœud sain peut piloter l'ensemble sans serveur de contrôle central dédié. Les fonctionnalités officielles de Proxmox VE décrivent cette couche comme une gestion intégrée, distincte du stockage des disques invités.
Cette distinction est essentielle. Le fichier de configuration d'une VM peut être connu de trois nœuds alors que son disque n'existe que sur le premier. Dans ce cas, le cluster sait que la VM existe, mais les deux autres n'ont rien à démarrer après la panne du disque local. Il faut donc traiter trois plans ensemble :
- le contrôle, avec pmxcfs, Corosync et le quorum ;
- les données, avec un stockage partagé ou répliqué ;
- l'exécution, avec assez de CPU, de mémoire et de réseau sur les nœuds restants.
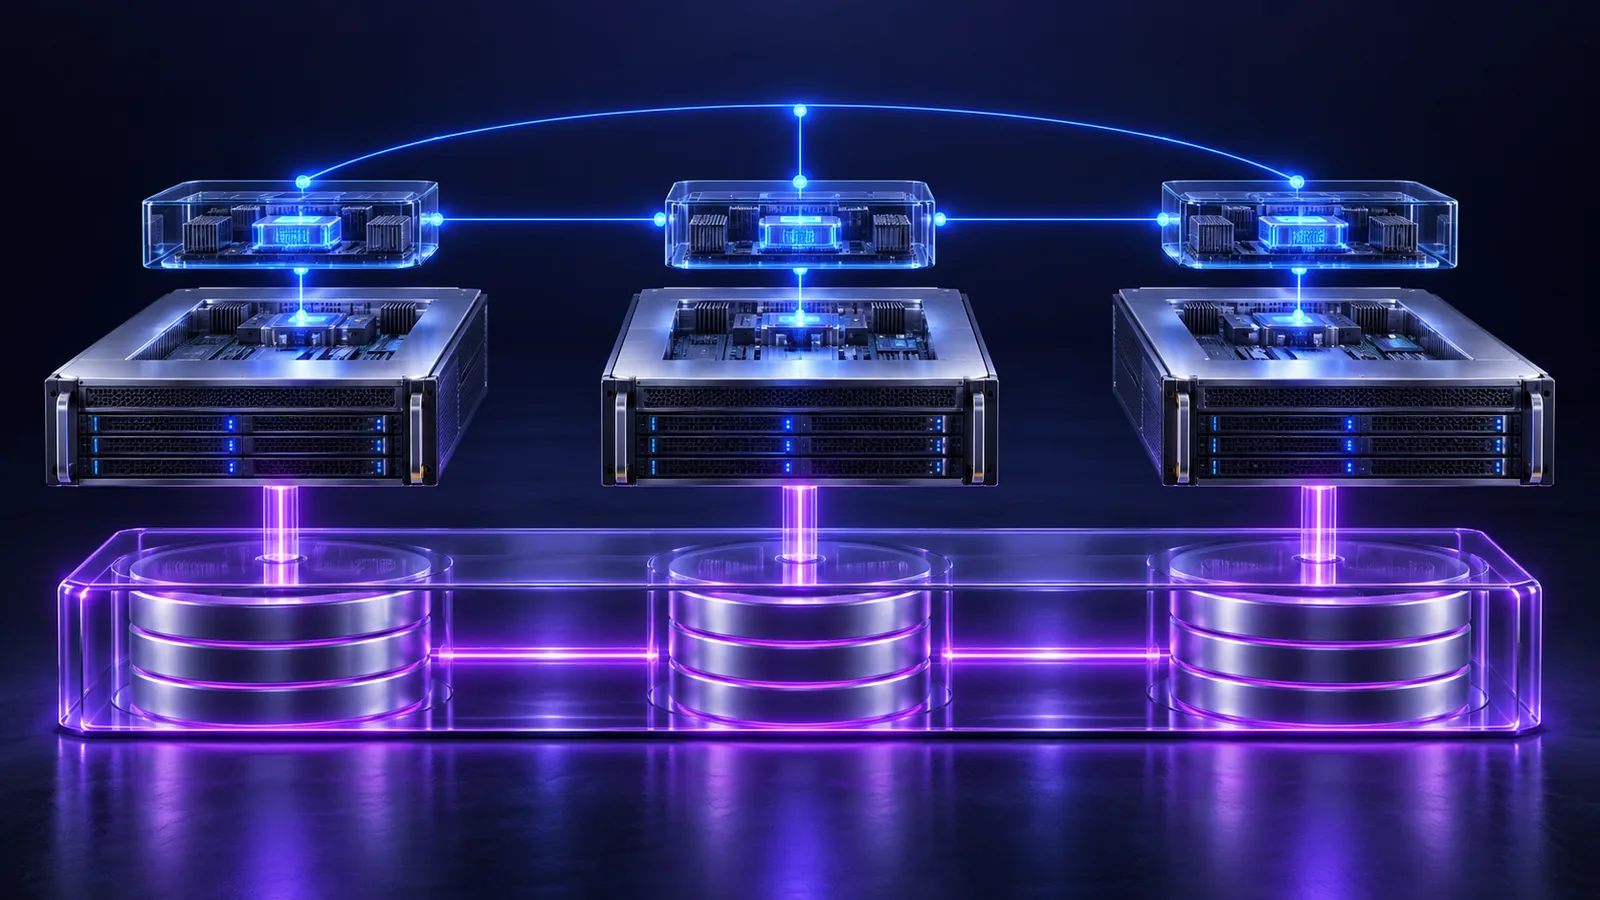
Un cluster facilite aussi la migration d'une VM entre deux hôtes. Une migration planifiée peut servir à maintenir un nœud, équilibrer une charge ou remplacer un matériel. Elle ne prouve pas que la plateforme saura réagir à une coupure brutale. La haute disponibilité ajoute la surveillance des ressources et leur redémarrage automatique après que le cluster a établi quel nœud peut agir sans risque de double démarrage.
Le choix du palier d'hébergement entre mutualisé, VPS et serveur dédié précède cette décision. Un cluster Proxmox concerne le niveau infrastructure : il devient pertinent quand une panne d'hôte ne doit plus imposer une reconstruction ou une intervention manuelle avant le retour du service.
Quorum et Corosync : pourquoi trois nœuds
Le quorum est l'autorisation collective de modifier l'état du cluster. Chaque nœud dispose d'un vote par défaut ; une majorité des votes attendus doit rester joignable. Dans un ensemble de trois nœuds, deux votes forment cette majorité. Si le troisième tombe ou perd le réseau, les deux nœuds qui communiquent continuent à gérer les ressources.
Cette règle évite le split-brain. Lors d'une partition réseau, deux groupes pourraient croire que l'autre est en panne et démarrer la même VM des deux côtés. Deux systèmes écrivant simultanément sur les mêmes données peuvent les corrompre. Le côté sans quorum cesse donc les opérations sensibles au lieu de prendre une décision ambiguë.
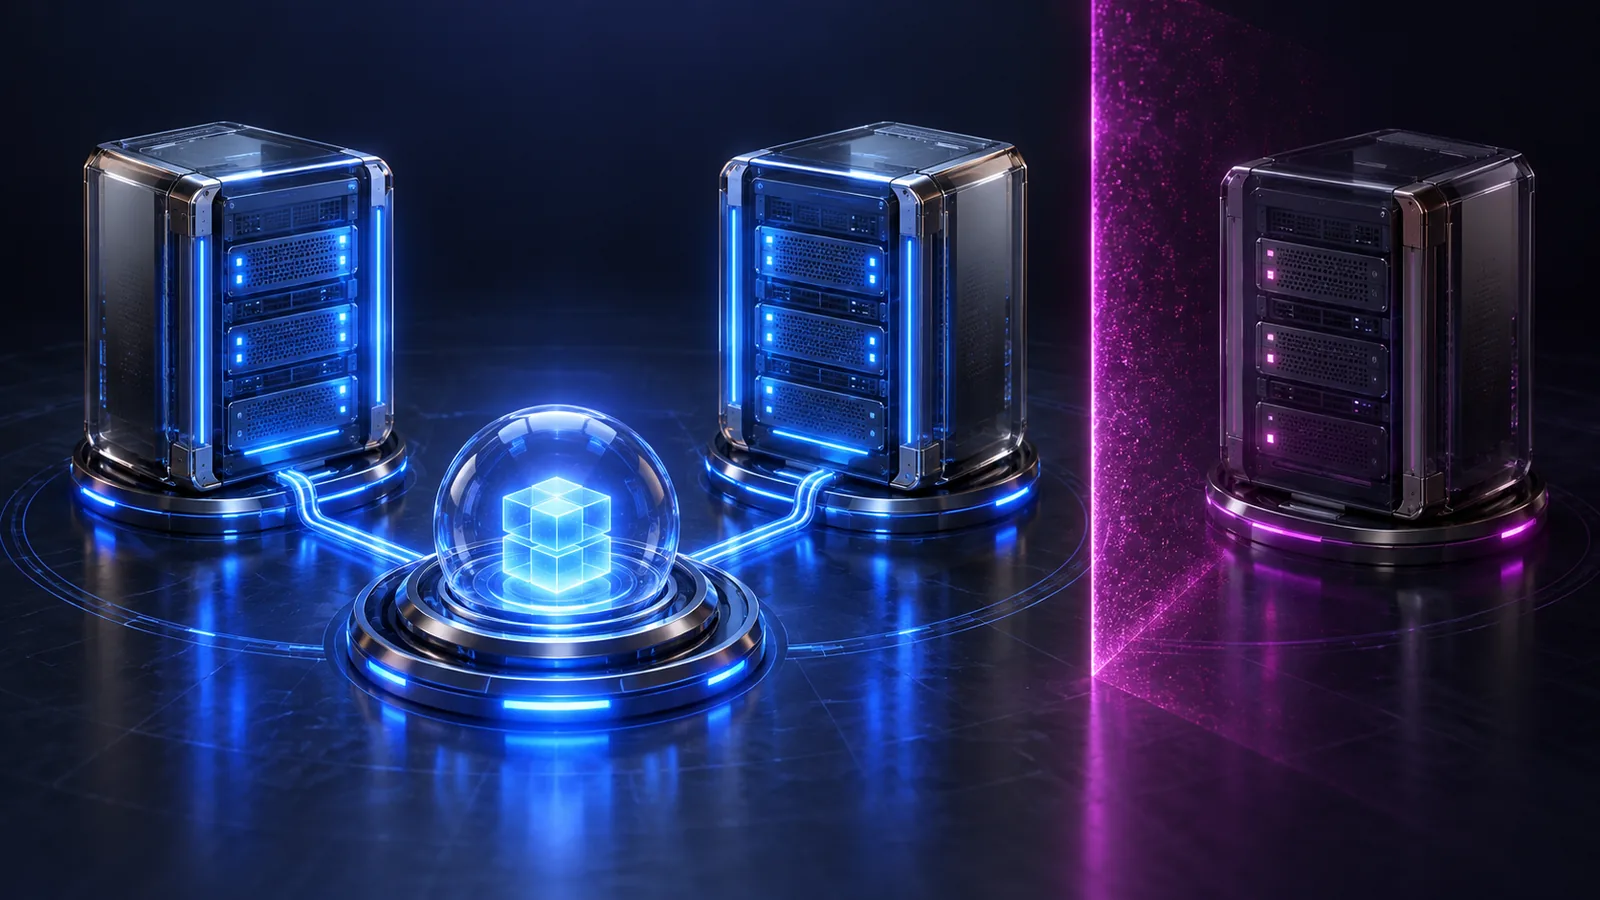
Avec deux nœuds, une coupure du lien produit un vote contre un vote. Aucun serveur ne peut savoir s'il est isolé ou si l'autre est réellement arrêté. La documentation d'administration Proxmox VE recommande au moins trois nœuds pour une configuration de quorum fiable.
Un QDevice permet d'ajouter un vote extérieur sans installer un troisième hyperviseur. Le service corosync-qnetd s'exécute sur un système indépendant et aide à départager les deux nœuds. Il doit vivre dans un domaine de panne distinct et conserver une connectivité fiable avec eux. Ce n'est pas un stockage, un hyperviseur de secours ou une sauvegarde : il vote seulement. Proxmox avertit aussi qu'une perte du QDevice combinée à une autre défaillance peut retirer le quorum. L'architecture réduit le coût matériel, mais ajoute un élément à superviser et à documenter.
Le quorum n'exprime pas la santé d'une application. Trois votes valides n'indiquent ni qu'une base répond, ni qu'un disque invité est cohérent. Il sécurise les décisions du cluster ; les contrôles applicatifs, le stockage et les procédures de reprise restent des couches séparées.
Réseaux du cluster : séparer les flux critiques
Corosync échange de petits messages sensibles à la latence et à la perte de paquets. Proxmox demande un réseau local fiable, avec une latence inférieure à environ 5 ms ; au-delà de 10 ms, la stabilité se dégrade nettement. Un cluster étiré entre des sites éloignés sur Internet ne se conçoit donc pas comme trois machines placées sur le même commutateur.
Le réseau de production d'un cluster porte plusieurs flux qui n'ont pas le même comportement :
| Flux | Priorité | Risque en cas de saturation |
|---|---|---|
| Corosync | Latence stable, très peu de pertes | Perte de quorum, bascules inutiles |
| Migration | Débit élevé pendant une opération | Migration lente, charge prolongée |
| Ceph ou stockage partagé | Débit, latence et régularité | I/O lentes, VM dégradées |
| Trafic des VM | Selon l'application | Service lent ou inaccessible |
| Sauvegardes | Débit planifiable | Concurrence avec la production |
Réserver une interface ou un VLAN au trafic Corosync limite les interactions avec une migration ou une sauvegarde. Proxmox peut configurer plusieurs liens Corosync pour la redondance ; ils doivent emprunter des chemins réellement indépendants pour qu'une panne de commutateur ou de carte réseau ne coupe pas les deux.
Ceph demande une autre échelle. La documentation Proxmox recommande au moins 10 Gb/s dédiés pour le trafic de stockage et davantage, par exemple 25 Gb/s, lorsque les supports rapides ou la charge le justifient. Une liaison rapide sur le papier ne suffit pas : files d'attente, surabonnement du commutateur, MTU incohérent ou ports partageant la même panne peuvent annuler le bénéfice attendu.
Le dimensionnement doit inclure le trafic de reconstruction après la perte d'un disque ou d'un nœud. C'est précisément au moment où le cluster est dégradé que Ceph réplique de nouveau les données. Si le réseau n'a aucune marge, la réparation concurrence les VM au moment le moins favorable.
Stockage : Ceph, partagé ou réplication ZFS
Pour redémarrer une VM sur un autre nœud, son disque doit y être utilisable. Trois modèles répondent à ce besoin, avec des garanties différentes.
Ceph intégré
Ceph distribue les données entre plusieurs serveurs et maintient des copies selon la politique choisie. Intégré à Proxmox, il permet à chaque nœud autorisé d'accéder aux disques RBD des VM sans baie centrale. Les prérequis matériels officiels de Proxmox VE préconisent au moins trois serveurs pour Ceph, de préférence homogènes, ainsi qu'un réseau de stockage dédié. La mémoire, le nombre de disques et les domaines de panne doivent être dimensionnés pour que le cluster reste exploitable pendant une reconstruction.
Ceph convient lorsque l'on veut éviter qu'une baie externe devienne le point unique de panne. Il ne rend pas une petite configuration illimitée : perdre un nœud retire simultanément du calcul et une part du stockage, puis déclenche une réparation. Garder assez de capacité libre est donc une condition de reprise, pas un confort.
Stockage partagé externe
Un SAN ou un NAS compatible peut présenter les mêmes disques à plusieurs hyperviseurs. La migration et le redémarrage deviennent simples puisque le volume ne se déplace pas. La disponibilité dépend alors de la baie, de ses contrôleurs, de ses chemins réseau et de son alimentation. Une seule cible NFS sans redondance déplace le point unique de panne au lieu de le supprimer.
Cette option reste cohérente lorsqu'une infrastructure de stockage hautement disponible existe déjà et que son exploitation est maîtrisée. Il faut tester la perte d'un chemin, d'un contrôleur et du réseau de stockage, pas uniquement la panne d'un hôte Proxmox.
ZFS local et réplication
Proxmox sait répliquer périodiquement des volumes ZFS d'un nœud à un autre. Le modèle limite le besoin d'une baie partagée et conserve les performances du disque local. La réplication est toutefois asynchrone : le nœud secondaire détient le dernier état transmis, pas chaque écriture confirmée à la milliseconde. L'objectif de point de reprise dépend donc de la fréquence et du succès des tâches.
La réplication ZFS peut convenir à des services capables d'accepter cet écart, surtout avec un QDevice ou trois nœuds. Elle demande de surveiller les tâches en échec et de prévoir l'espace nécessaire aux instantanés. Pour une base exigeant zéro perte d'écriture confirmée, la cohérence doit être traitée au niveau du stockage ou de l'application ; la réplication périodique ne suffit pas à formuler cette promesse.
Haute disponibilité : bascule et limites
Dans Proxmox, le gestionnaire HA surveille les nœuds et les ressources déclarées. Après une panne d'hôte, il doit s'assurer que l'ancien nœud ne peut plus exécuter la VM avant de la démarrer ailleurs. Ce mécanisme de fencing s'appuie sur le watchdog et sur l'état du cluster. Sa prudence évite deux instances concurrentes, mais ajoute un délai avant la reprise.
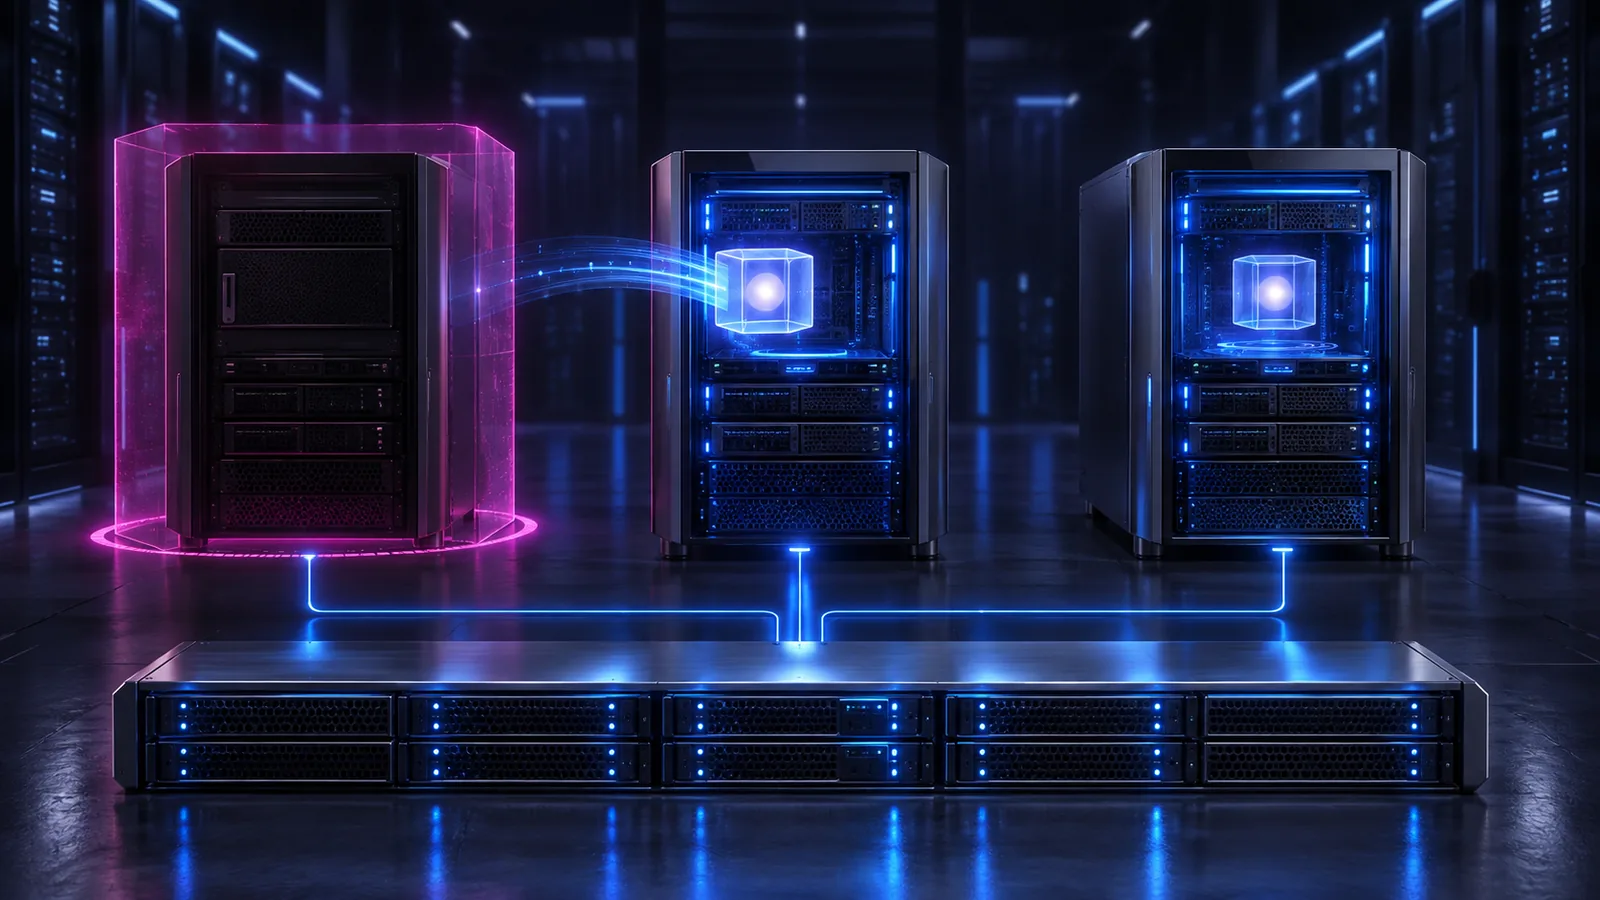
Une bascule HA n'est donc pas une migration à chaud. Lors d'une migration planifiée, les deux hôtes communiquent et transfèrent l'état de la VM. Après une panne électrique ou matérielle, la mémoire du processus a disparu. La VM redémarre depuis son disque sur un autre nœud, comme après un arrêt brutal. Le délai réel additionne la détection, la sécurisation de l'ancien hôte, le démarrage de la VM et le temps de retour de l'application.
Trois conditions déterminent alors le résultat :
- capacité N+1 : les nœuds restants disposent de la RAM, du CPU et des accès réseau nécessaires ;
- ordre de reprise : les dépendances démarrent avant les services qui les utilisent ;
- contrôle applicatif : la VM démarrée ne vaut pas une application disponible si sa base ou son service externe reste en erreur.
Les groupes HA permettent de définir des préférences et de limiter les nœuds qui peuvent recevoir une ressource. Il faut éviter des règles trop rigides : si une VM n'est autorisée que sur un hôte indisponible, le cluster ne peut pas la reprendre. Testez aussi le retour à la normale. Déplacer toutes les ressources vers le premier nœud revenu peut recréer une surcharge ou solliciter le stockage pendant sa reconstruction.
La HA ne couvre ni la suppression d'un fichier, ni une erreur d'administration, ni un ransomware dans la VM. Pour ces risques, une stratégie de sauvegarde indépendante reste nécessaire, même lorsque la charge n'est pas WordPress : plusieurs copies, un support ou emplacement distinct et une restauration testée.
Cluster Proxmox à deux ou trois nœuds
Le choix ne se résume pas au prix d'un serveur supplémentaire. Il porte sur la manière dont le cluster décide, stocke et absorbe une panne.
| Critère | Deux nœuds + QDevice | Trois nœuds |
|---|---|---|
| Quorum | Deux votes sur trois avec un service extérieur | Deux nœuds sur trois, sans arbitre externe |
| Perte d'un hyperviseur | Reprise possible si QDevice et second nœud restent joignables | Reprise possible sur la majorité restante |
| Maintenance | Peu de marge si un nœud porte déjà la charge complète | Répartition plus souple, selon le dimensionnement |
| Stockage | Partagé ou réplication à concevoir séparément | Ceph possible à partir de trois serveurs, sans obligation |
| Complexité cachée | Hébergement, réseau et supervision du QDevice | Coût et exploitation d'un nœud complet de plus |
| Cas adapté | Petit périmètre, charge maîtrisée, compromis assumé | Production qui privilégie une décision de quorum native |
Un cluster à deux nœuds peut être une conception valide lorsqu'un troisième hyperviseur n'est pas justifié, que le QDevice vit ailleurs et que le stockage répond au scénario de panne. Il devient fragile si le vote extérieur est installé sur l'un des deux nœuds, si les deux chemins réseau passent par le même équipement ou si chaque nœud est rempli à plus de la moitié de sa capacité alors qu'il doit accueillir l'autre.
Trois nœuds rendent le quorum plus direct, mais ne corrigent pas un dimensionnement N+1 absent. Si chaque serveur consomme 80 % de sa mémoire avant la panne, les deux survivants ne pourront pas reprendre l'intégralité des VM. Définissez donc les services prioritaires et calculez leur consommation en pic. La capacité brute du cluster ne doit pas être confondue avec la capacité utilisable après perte d'un nœud.
Le stockage peut aussi imposer un autre nombre de machines. Ceph fonctionne à partir de trois serveurs, mais une plateforme qui doit maintenir performances et réplication pendant une maintenance peut demander davantage de domaines de panne. La bonne taille découle du niveau de service visé, des charges mesurées et de la panne que l'on décide de tolérer.
Checklist avant la mise en production
Avant d'activer la HA, vérifiez ces points avec un scénario de panne écrit :
- Rôles et votes. Le nombre de votes attendu, l'emplacement du QDevice éventuel et le comportement en cas de partition sont documentés.
- Horloge et noms. Tous les nœuds ont une résolution cohérente, des adresses stables et une synchronisation horaire valide.
- Chemins réseau. Corosync, stockage, migrations et VM disposent des VLAN, interfaces et débits prévus ; chaque redondance emprunte un équipement distinct.
- Accès aux disques. Une VM représentative peut être démarrée depuis un autre nœud avec ses données cohérentes.
- Capacité N+1. CPU, mémoire, stockage et réseau restent sous leurs seuils après retrait du plus gros nœud.
- Ordre et priorités. Les services essentiels ont un ordre de démarrage, des délais et des règles HA compatibles avec leurs dépendances.
- Sauvegarde restaurable. Une copie indépendante du cluster est disponible et sa restauration a été chronométrée.
- Supervision. Quorum, latence Corosync, santé du stockage, tâches de réplication et capacité libre déclenchent des alertes exploitables.
- Test de panne. Perte d'un hôte, d'un lien et d'un chemin de stockage sont testées séparément pendant une fenêtre maîtrisée.
- Retour en service. La réintégration d'un nœud et le rééquilibrage ne saturent ni le réseau ni le stockage.
Le guide de migration vers Proxmox VE rappelle les prérequis de ports, de latence et de stockage. Utilisez-le avec le guide d'administration de la version réellement installée : une procédure écrite pour une autre branche ne doit pas devenir la seule référence d'exploitation.
Un test réussi doit décrire ce qui a été observé : durée avant démarrage sur le nœud de secours, état de l'application, données présentes, alertes reçues et charge résiduelle. « La HA fonctionne » ne permet pas de comparer deux essais ni de repérer une dérive.
Quand confier un cluster Proxmox à Tomco
Une plateforme managée devient pertinente lorsque le besoin porte sur un résultat d'exploitation — redémarrage contrôlé, surveillance, sauvegarde et capacité de reprise — plutôt que sur l'accès seul à trois serveurs. L'étude doit partir du service à protéger : charge de pointe, dépendances, volume de données, délai de reprise et perte de données acceptable.
Tomco exploite Proxmox VE avec KVM et LXC sur ses infrastructures et documente le basculement automatique de ses clusters sur la page technologies d'hébergement. Les architectures de serveurs dédiés sur mesure proposent des réseaux de 1 à 100 Gb/s selon le besoin : ce chiffre ne fixe pas le débit à acheter, il montre pourquoi le calcul doit séparer trafic des VM, réplication, stockage et sauvegardes avant de choisir les interfaces.
Le périmètre doit ensuite préciser qui gère les mises à jour Proxmox, la santé Ceph ou ZFS, les règles HA, les tests de restauration et les alertes. Une haute disponibilité non testée reste une hypothèse. Un engagement utile décrit les scénarios couverts, les contrôles réalisés et les limites connues, notamment le délai de redémarrage applicatif après une panne brutale.
Pour cadrer un projet, préparez le nombre de VM, leur RAM et leur charge CPU en pic, le volume de stockage actif, le débit entre services, les dépendances et les objectifs RTO/RPO. Ces données permettent de comparer deux nœuds avec QDevice, trois nœuds et stockage externe, ou trois nœuds avec Ceph sans choisir l'architecture par réflexe.